Audio.cpp 本地文字配音 (TTS) 与声音克隆使用指南
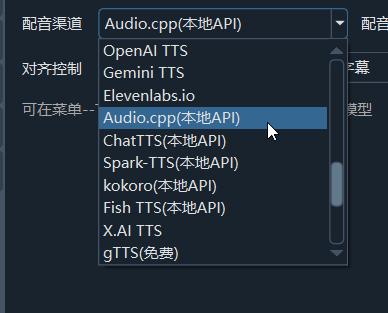
自 v4.16 版本起,软件新增了轻量、高效的本地 TTS 后端 audio.cpp。该后端支持多款顶尖的开源语音模型,主要用于本地声音克隆以及通过参考音频进行文字配音。
WARNING
⚠️ 重要权限提示(Windows 用户必读)
在 Windows 系统上,请务必以“管理员身份运行”本软件。否则在调用 audio.cpp 引擎时可能会因底层调用权限不足而报错中断。
一、下载并安装 audio.cpp 运行组件
audio.cpp 需要系统底层二进制执行文件(audiocpp_cli)的支持:
1. 自动下载(推荐)
- Windows / macOS:软件内置了自动下载机制,首次使用时会自动下载适配当前系统的预编译包:
- Windows 默认自动下载:
bin-windows-x64-cuda12.4.zip - macOS 默认自动下载:
bin-macos-arm64-metal.tar.gz
- Windows 默认自动下载:
- Linux / Ubuntu:暂不支持自动下载,需按下方步骤手动配置。
2. 手动下载与特殊配置
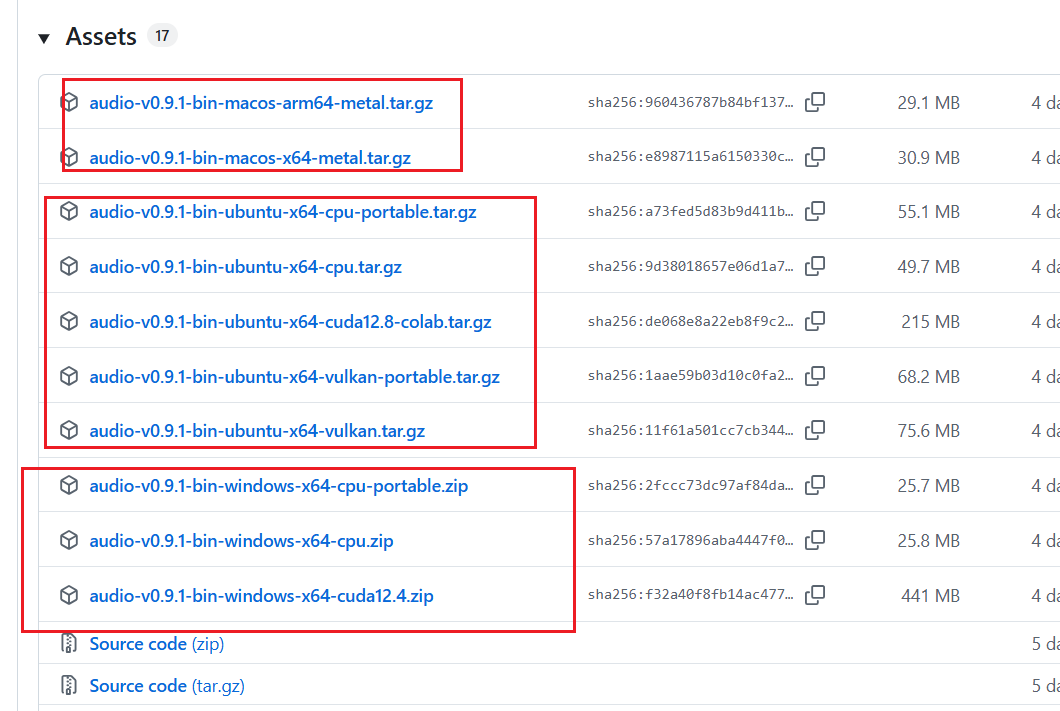
如果自动下载较慢,或想使用其他显卡如intel/amd显卡加速,可前往 audio.cpp 官方 Releases 手动下载:
| 操作系统 | 显卡类型 | 推荐下载版本 |
|---|---|---|
| Windows | 英伟达 (NVIDIA) 显卡 | bin-windows-x64-cuda 相关版本 |
| Windows | AMD 显卡 / 核显 / 纯 CPU | bin-windows-x64-vulkan 或 bin-windows-x64-cpu |
| macOS | Apple Silicon (M系列芯片) | bin-macos-arm64-metal |
| Linux | 根据具体硬件环境 | bin-ubuntu-x64-cuda / cpu / vulkan |
解压安装路径: 将下载的压缩包解压到 软件根目录/audio_cpp/ 文件夹中(若没有该文件夹可手动新建),确保该目录下能直接看到 audiocpp_cli.exe(Windows)或 audiocpp_cli(macOS/Linux)文件。
软件根目录/
  └── audio_cpp/
        ├── audiocpp_cli.exe (或 audiocpp_cli)
        └── ... 其他动态库文件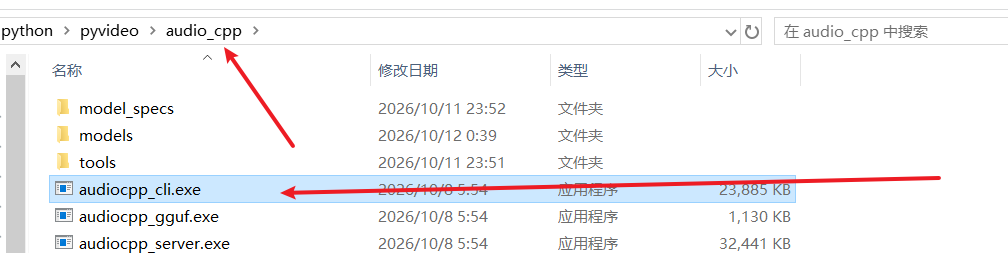
二、配置与使用
1. 打开配置界面
在软件顶部菜单栏点击:TTS设置 → Audio.cpp。 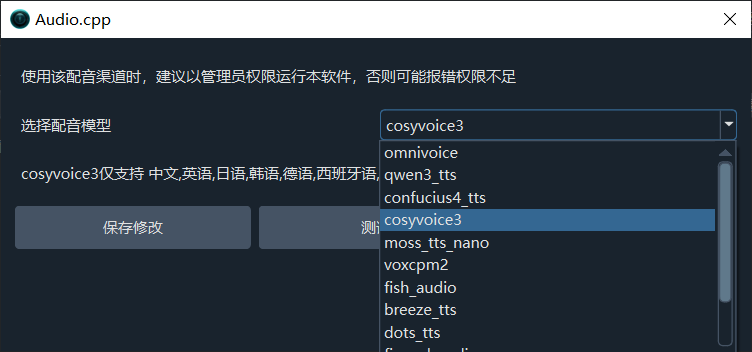
2. 功能操作说明
- 选择配音模型:下拉菜单中可选择你想使用的模型(默认推荐
omnivoice)。切换模型时,下方会实时提示该模型当前支持的语言。 - 测试 (Test):
💡 测试注意事项:audio.cpp 属于声音克隆引擎,测试时需要调用参考音频。软件会自动读取你之前在 F5-TTS 中添加的参考音频。如果提示 “No reference audio exists”,请先在声音克隆设置中添加至少一条参考音频再点击测试。
- 保存 (Save):保存当前选择的模型并关闭窗口。
三、内置模型介绍与支持语言
默认使用
omnivoice,兼容性最好且支持语言最全。 第一次使用时会自动下载所需模型,无需手动下载
手动下载模型方法
模型自动下载后存放到 软件目录/audio_cpp/models/[该模型对应文件夹名]/模型gguf文件文件夹内。
你也可以手动下载,但注意,下载的模型格式是 .gguf 文件,需要放在对应文件夹名内,具体名称和下载地址可打开软件目录/videotrans/voicejson/audiocpp.json查看该模型数据。
"qwen3_tts": {
    "type": "tts",
    "file": "Qwen3-TTS-12Hz-1.7B-Base-GGUF/qwen3-tts-12hz-1.7b-base-q8_0_v2.gguf",
    "url": "https://huggingface.co/audio-cpp/audio.cpp-gguf/resolve/main/Qwen3-TTS-12Hz-1.7B-Base-GGUF/qwen3-tts-12hz-1.7b-base-q8_0_v2.gguf?download=true",
	"support_languages":["zh", "en", "ja", "ko", "de", "fr", "ru", "pt", "es", "it"],
    "is_reference_text": true,
    "is_language": false,
    "is_seed": false
}其中"file":值是文件夹名/模型文件名,例如"file": "Qwen3-TTS-12Hz-1.7B-Base-GGUF/qwen3-tts-12hz-1.7b-base-q8_0_v2.gguf",则模型文件夹为软件目录/audio_cpp/models/Qwen3-TTS-12Hz-1.7B-Base-GGUF
其中"url": 是下载地址,复制该地址到浏览器中打开,可下载 gguf 模型文件
📌 中文支持说明:除
chatterbox/irodori_tts外,其余所有模型均支持中文。
| 模型名称 | 语言支持范围 | 特点与建议 |
|---|---|---|
| omnivoice(默认) | 支持软件所有内置语言 | 综合效果最佳,支持语言最多,推荐首选 |
| qwen3_tts | 中文、英语、日语、韩语、德语、法语、俄语、葡萄牙语、西班牙语和意大利语 | 语义理解与语调优秀 |
| cosyvoice3 | 中、英、日、韩、德、西、法、意、俄、粤语 (yue) | 阿里系列模型,中文表现及粤语极佳 |
| fish_audio | 支持 80+ 种主流语言 | 质量极高,多语言克隆推荐 |
| voxcpm2 | 中、英、日、韩、德、法、俄、泰、越等 30 种语言 | 涵盖主流东南亚及欧洲多国语言 |
| moss_tts_nano | 中、英、德、西、法、日、意、韩、俄、阿等 19 语 | 轻量快速,适合低配置设备 |
| moss_tts_local | 中、英、德、西、法、日、意、韩、俄、阿等 19 语 | 重型模型质量更佳,需要更大显存内存,适合高性能显卡 |
| confucius4_tts | 中、英、日、韩、德、法、西、意、泰、越等 14 语 | 综合语音克隆模型 |
| index_tts2 | 中、英、日、西、阿 | 基于 index_tts2.5,情感还原度高 |
| breeze_tts | 仅中文 (zh)、英文 (en) | 专注于中英文合成 |
| dots_tts | 仅中文 (zh)、英文 (en) | 专注于中英文合成 |
| firered_audio | 仅中文 (zh)、英文 (en) | 专注于中英文合成 |
| irodori_tts | 仅支持日语(ja)合成 | 专注日语合成 |
| higgs_audio_tts | 支持 80+ 种主流语言 | 泛用性高,语音表现自然 |
| chatterbox | 英、法、德、意、西、韩等 19 种语言(不支持中文) | 适合纯外语配音场景 |
四、进阶操作:手动添加新模型(高级用户)
⚠️ 警告:本步骤涉及 JSON 配置修改与命令行操作。普通用户无需修改,使用内置模型即可满足绝大多数需求。
audio.cpp 官方仓库支持的模型很多,如果你想体验官方更新的新模型,可按以下步骤手动接入:
第一步:确认模型是否支持声音克隆
- 访问 audio.cpp 官方 TTS 模型文档。
- 找到你要添加的模型,点击进入其详情页。
- 必须确保该模型文档中包含
Voice Cloning(声音克隆)示例,否则无法接入本软件。
第二步:获取模型参数与下载信息
在终端(Terminal / CMD)中执行以下命令(查询具体信息,避免文档更新滞后):
python tools/model_manager_v2.py info <你的模型家族名>例如查看 higgs_audio_tts,控制台将输出类似:
id: higgs_audio_tts_4b_q8_0
family: higgs_audio_tts
target: Higgs-Audio-v3-TTS-4B-GGUF
file: Higgs-Audio-v3-TTS-4B-GGUF/higgs-audio-v3-tts-4b-q8_0.gguf第三步:修改软件配置文件
打开文件:软件目录/videotrans/voicejson/audiocpp.json
在最后一个花括号前加上英文逗号 ,,并按以下模板追加你的模型配置:
  "你的模型唯一标识名称": {
    "type": "tts",
    "file": "模型文件相对路径",
    "url": "https://huggingface.co/audio-cpp/audio.cpp-gguf/resolve/main/模型文件相对路径?download=true",
    "support_languages": ["zh", "en"],
    "is_reference_text": true,
    "is_language": false,
    "is_seed": true
}参数配置对照表:
type:参考文档示例中的--task参数。如果示例中写的是clon则填"clon",若是tts则填"tts"。file:填入命令行输出中file:后面的完整路径。url:固定格式为:https://huggingface.co/audio-cpp/audio.cpp-gguf/resolve/main/[这里替换为file的值]?download=true。support_languages:该模型支持的语言缩写列表(若不清楚具体语言限制,可直接删除该行)。is_reference_text:查看文档的 Voice Cloning 示例命令中是否包含--reference-text,包含则为true,否则为false。is_language:查看文档示例 或Common Options命令中 是否包含--language参数,包含则为true,否则为false。is_seed:如果文档选项(Request Options)中支持--seed,建议设为true,否则设为false。
保存文件后重新打开软件,即可在设置界面的模型下拉菜单中看到你新添加的模型。