使用文档-全面指南
本页面文档匹配
v4.17版本
核心功能:视频翻译 / 语音转录 / 文字配音 / 翻译字幕
- 视频翻译:将A语言发音的视频,翻译为B语言发音和B语言字幕的视频,(左侧功能面板:翻译视频)
- 语音转录/语音识别:批量将音视频中的人类说话声,转录为带时间轴的 SRT 字幕文件 (左侧功能面板:语音转录)
- 语音合成/文字配音:利用多种本地TTS模型或在线API,为字幕 或 文本生成高质量的配音 (左侧功能面板:文字配音)
- 翻译字幕:支持批量翻译 SRT 字幕文件,保留原有时间码和格式 (左侧功能面板:翻译字幕)
问: 软件是否收费或需订阅?
答: 本软件开源、免费,不收取任何费用,也无需登录或订阅,源码部署或下载 Windows 预打包版本后即可直接使用。
问: 是否有额度、时长、功能等限制?
答: 软件本身不做任何限制,支持 本地模型、免费API、付费API 等多种渠道,如果使用前两种(本地模型/免费API),无需任何花费,如果使用 付费API(如 DeepSeek/Gemini),你需自行在相应平台充值并获取密钥,将密钥填写在软件中,费用由对应厂商直接收取,软件仅提供技术对接方案。
问: 翻译结果能否上传到 Youtube 等平台?版权如何解决?
答: 完全可以,上传到哪由你自行决定。至于视频内容本身是否拥有版权、是否允许二次发布,属你与权利人之间的事项,软件不涉及也无从判断。
软件集成部分开源模型(如 Whisper/OmniVoice/Qwen3-ASR 等),若有用到,请自行搜索查看对应模型开发商的开源协议。
问: 全都免费,那你们如何盈利?
答: 这是基于兴趣创建的个人开源项目,无商业模式及盈利计划,如你所见,仅在文档网站放置部分Google广告及赞助链接,用于支持文档服务器及测试token开销。欢迎赞助,一定的赞助能帮助项目更长久维护。捐赠链接
问: 免费/本地API/内置 是什么意思?
- 免费: 例如 Google翻译、微软翻译、Edge-TTS配音,这些渠道都是在线免费使用的,无需配置开箱即用,只是需注意有限流错误,高频使用时可能会遇到报错
- 内置: 有些模型可以相对方便的集成到 pyVideoTrans 软件内,而无需单独另行部署,开箱可用,例如 VITS/Piper/Qwen3-TTS/ OmniVoice / F5-TTS / Qwen3-ASR/SuperionTTS/ChatterBox等,但需要注意,为避免软件体积无限膨胀,仅调用代码内置,模型本身并未内置,第一次使用时需在线下载模型。
- 本地API: 很多开源模型可自行在本地部署,部署并启动后,将API地址或WebUI地址填写在 pyVideoTrans 软件设置界面,软件即可通过该地址调用你部署的模型服务。例如 GPT-SoVITS / CosyVoice 等
一、软件工作原理
本软件的核心功能是 翻译视频 ,将一种语言的视频 翻译为 另一个语言发音和字幕的视频:
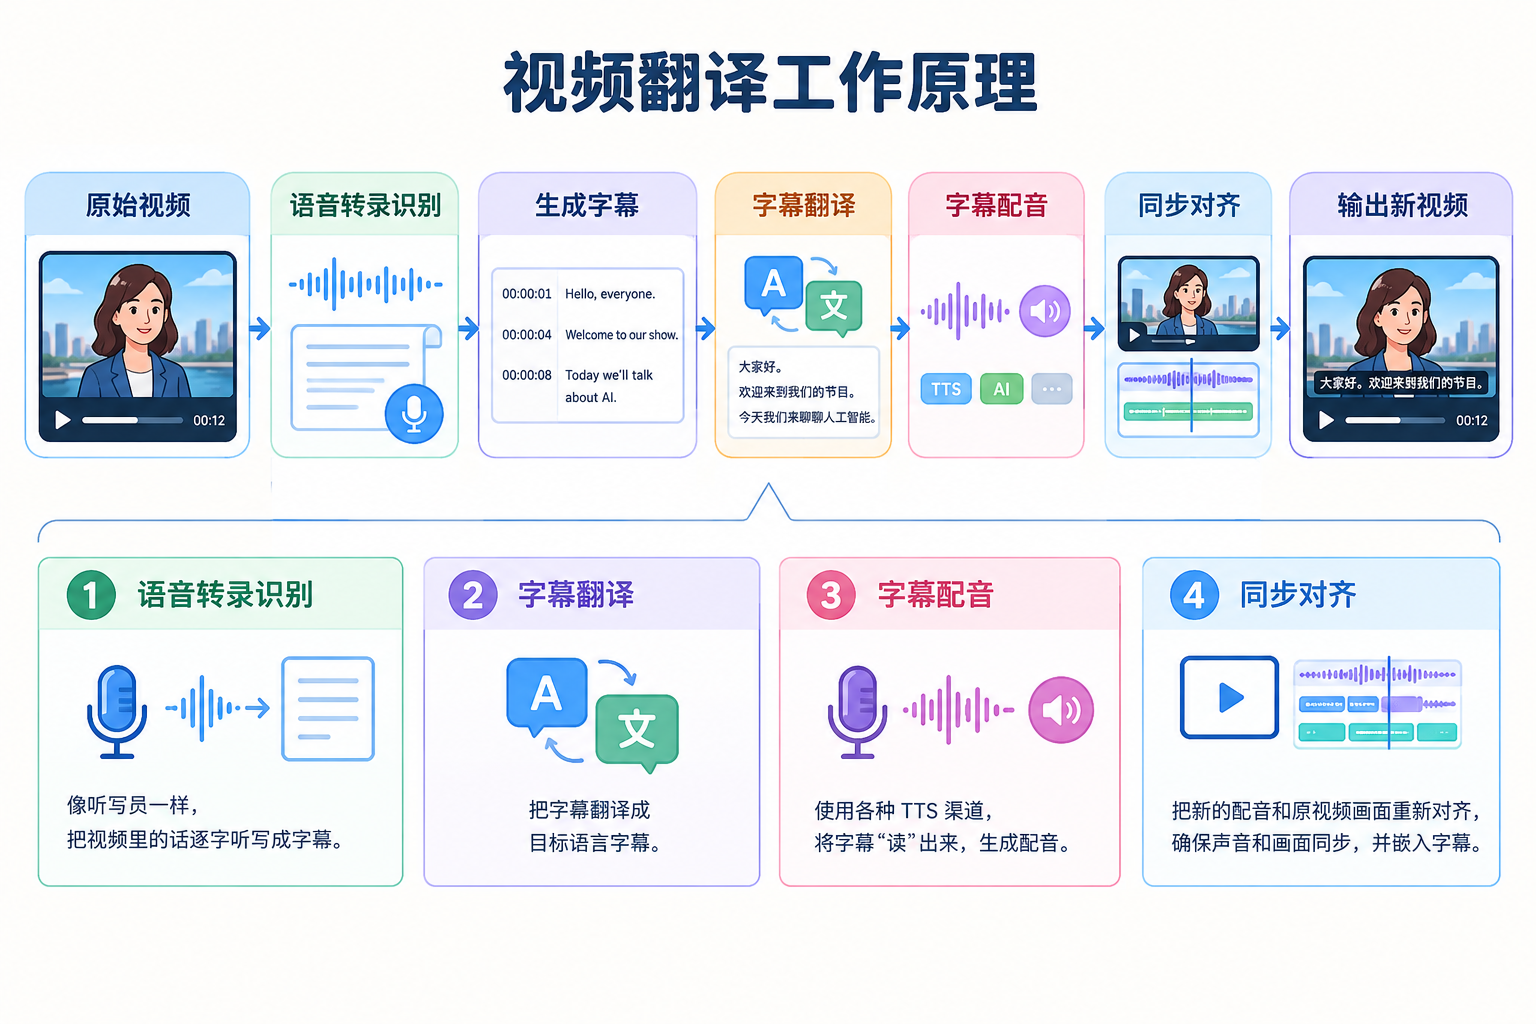
- 语音转录/识别:像听写员一样,把视频里人物说的话逐字听写成字幕
- 字幕翻译:把听写出来的字幕翻译成目标语言字幕
- 文字配音:即语音合成,使用各种TTS渠道将字幕使用某种音色"读"出来,生成配音
- 同步对齐:把新的配音和原视频画面重新对齐,确保声音和画面同步,并嵌入字幕,生成新视频
整个过程完全自动化,您只需选择文件和设置参数,点击开始即可。
- 可处理:任何包含清晰人类语音的音视频(无论视频本身是否有字幕)。
- 无法处理:仅有背景音乐/画面但无人声说话的视频。
- 无法抹除视频中的硬字幕
二、下载与安装
Windows 用户
- 可下载预打包版本:点击下载Windows版
- 建议解压到 只包含英文及数字的简短路径中(如
D:\pyVideoTrans) - 双击
sp.exe启动,请勿直接在压缩包内双击 sp.exe 运行。
点击查看新手注意事项(避开 90% 的常见报错)
为了保证软件正常运行,避免各种报错,使用前请花 1 分钟了解以下三点:
1. 软件解压到哪里?
- ✅ 推荐位置:解压到一个简单的文件夹中,例如
D:/videotrans(路径越短越好)。 - ❌ 千万别放:不要解压到
C:/Program Files或C:/Windows等系统核心目录(这类目录限制多,软件无法保存生成的视频和临时文件)。
2. 关闭安全软件或将软件所在文件夹加入 信任名单
软件使用python简单打包,未做认证和签名,一些安全软件可能误报病毒或拦截,请提前加入信任名单,并使用管理员权限运行。
若有安全顾虑,建议使用 源码部署,查看源码部署方法
3. 视频怎么命名和存放?(最常见报错原因!)
- ❌ 千万别偷懒:从 YouTube、B站 等下载的视频,名字通常超级长还带有表情符号(如 🔥、👍、🌟),直接导入极易导致 Windows 系统崩溃报错。
- ✅ 最稳妥做法:导入前,先把视频改成简短的名字(例如
video1.mp4或我的采访.mp4,删掉所有表情和特殊符号),并放在浅层目录(如桌面或 D 盘)。
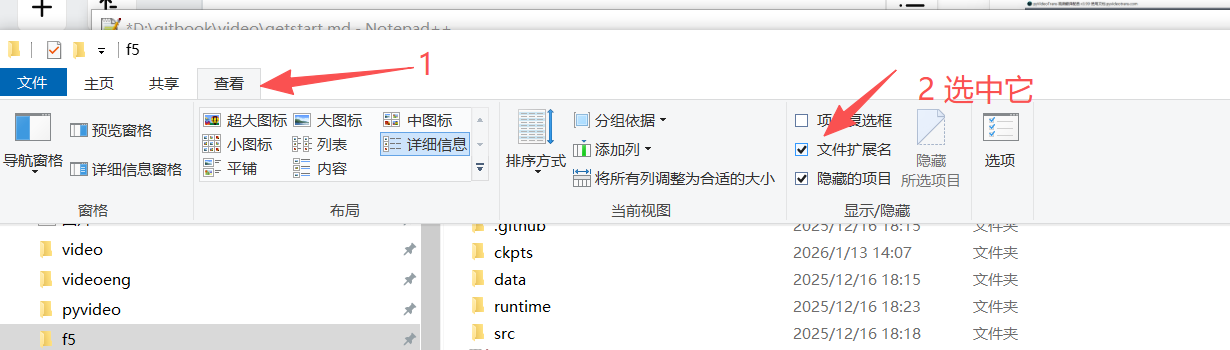
4. 建议开启“显示文件后缀名”(防止选错文件)
Windows 默认会隐藏后缀名,导致你分不清哪个是视频、音频或字幕文件,尤其当他们名字一样时。
- 开启方法:随便打开一个电脑文件夹,点击顶部的 「查看」 ➔ 勾选 「文件扩展名」 即可(如下图)。
MacOS / Linux 用户查看安装方法
安装依赖:
bash# macOS brew install libsndfile git brew tap homebrew-ffmpeg/ffmpeg brew install homebrew-ffmpeg/ffmpeg/ffmpeg # Ubuntu/Debian sudo apt-get install ffmpeg libsndfile1-dev安装 uv:
bashcurl -LsSf https://astral.sh/uv/install.sh | sh克隆并启动:
bashgit clone https://github.com/jianchang512/pyvideotrans.git cd pyvideotrans uv sync uv run sp.py
三、界面概览
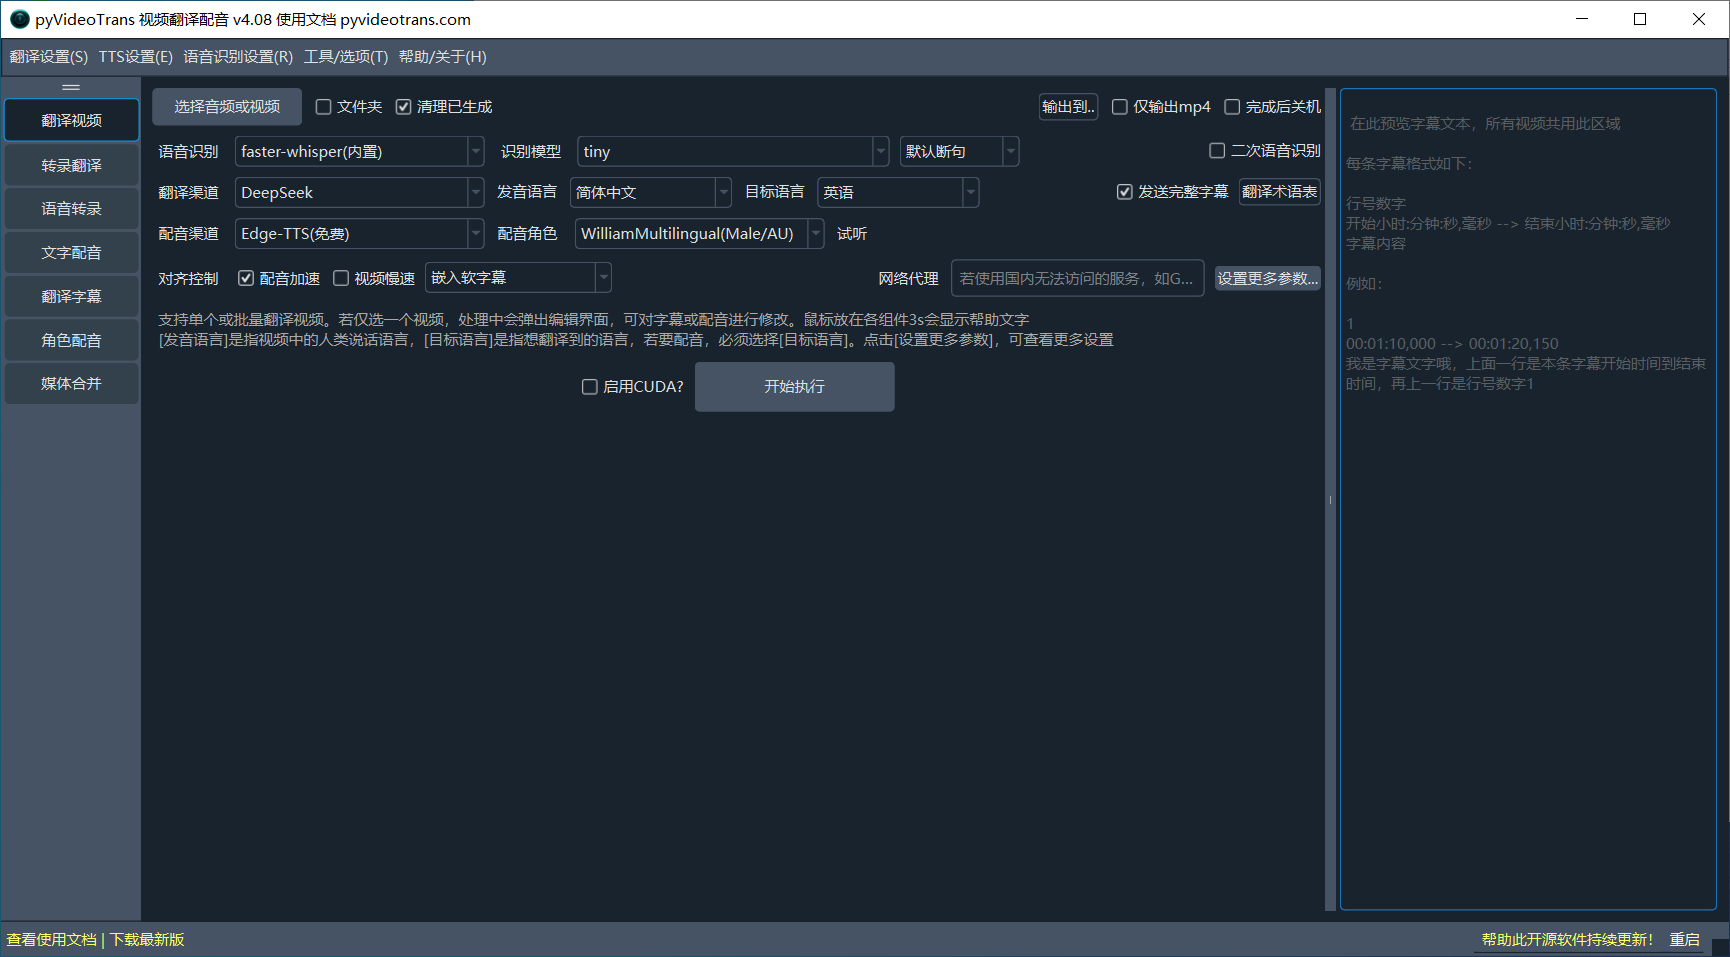
启动软件后,主界面从上到下分为以下几行:
| 行 | 内容 | 说明 |
|---|---|---|
| 1 | 选择待翻译的视频 (必须) | 支持 mp4/mkv/avi/mov/wav/mp3 等格式,支持一次选择多个视频进行批量翻译 |
| 2 | 语音识别渠道行 | 选择语音识别渠道和模型,用于将说话声转为字幕 (默认faster-whisper/large-v3-turbo) |
| 3 | 字幕翻译渠道行 | 选择字幕翻译渠道、源语言和目标语言,用于翻译上一步识别出的字幕 (默认Google翻译) |
| 4 | 配音渠道行 | 选择配音渠道和发音角色,为翻译好的字幕进行配音 (默认 Edge-TTS) |
| 5 | 同步对齐行 | 音频加速、视频慢速、嵌入字幕、代理设置 (默认仅选中音频加速) |
| 6 | 开始执行按钮 | 点击后开始处理 |
| 7 | 进度条 | 显示处理进度,点击进度条可打开输出文件夹,若红色报错时点击显示详细报错信息 |
| 8 | 设置更多参数 | 可选择降噪、分离人声背景声、重新嵌入背景声等高级选项 |
| 9 | 右侧字幕显示预览区 | 只读区域,会实时显示识别或翻译后的字幕 |
| 10 | 右侧字幕显示区底部2个导入字幕按钮 | 对于单视频翻译,可导入发音语言字幕或导入目标语言字幕,可跳过语音识别或字幕翻译过程 |
四、翻译视频的详细步骤
步骤 1:选择待翻译的视频文件

界面元素:
选择视频或音频: 点击左上角按钮,选择您要翻译的文件。支持 mp4/mkv/avi/mov/wav/mp3 等格式,一次可选择一个或多个文件,若仅选择一个视频,将进入单视频模式,过程中会弹出几次编辑界面,允许你修改字幕、重新配音等调整。文件夹:勾选此项可批量处理整个文件夹内的所有视频。清理已生成:若需对同一视频重新翻译,请勾选此项,否则会使用上次已生成过的文件,例如已转录好的srt字幕、已翻译过的srt字幕,如果你重复翻译同一个文件,并且想跳过耗时的语音转录阶段,请取消选中。输出到...:点击此按钮可单独设置翻译后视频的输出目录,不指定则使用默认仅输出mp4:如果选中,则输出中只保留最终的翻译视频,其他字幕、音频等文件都会自动删除。完成后关机:处理完所有任务后自动关闭计算机,适合大批量、长时间任务。
查看翻译结果输出到了哪里
未勾选
文件夹时默认输出位置: 所选视频同级的_video_out文件夹内,例如所选视频是D:/videos/001.mp4,则输出到D:/videos/_video_out内,每个视频生成一个结果文件夹,名字是{视频名字(不含后缀)}-{视频后缀名},例如D:/videos/_video_out/001-mp4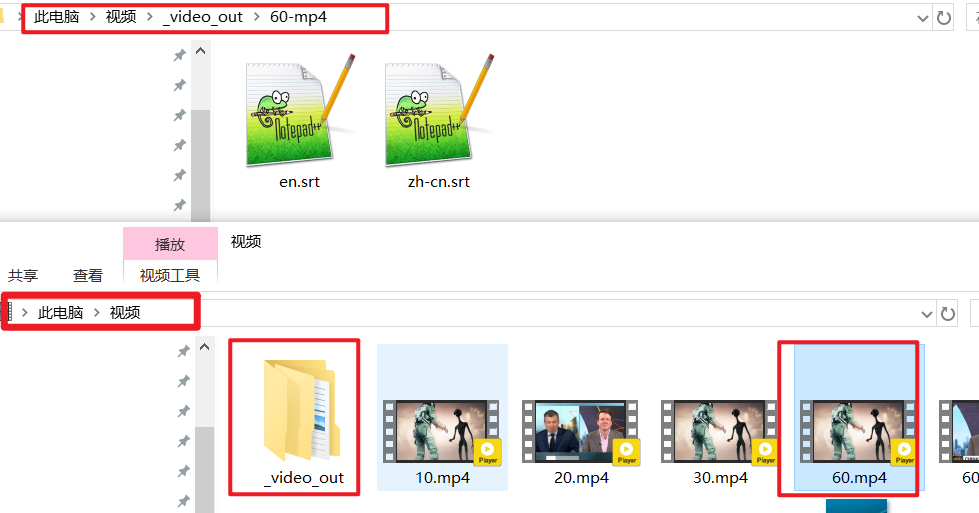
若勾选
文件夹时默认输出位置: 所选文件夹同级的_video_out/{该文件夹名}下,例如所选文件夹是D:/videos/ceshi, 输出到D:/videos/_video_out/ceshi文件夹内,每个视频生成一个结果文件夹,名字是{视频名字(不含后缀)}-{视频后缀名},例如D:/videos/_video_out/ceshi/001-mp4点击进度条会自动打开输出文件夹
当点击了输出到...自定义输出位置后,将不再保存到默认位置,而是你指定的位置
步骤 2:选择语音识别渠道
这一步骤用于将视频中的说话声转录为字幕,将直接决定后续翻译和配音的质量

界面元素:
语音识别:
| 渠道 | 推荐场景 | 说明 |
|---|---|---|
faster-whisper(内置) | 默认,tiny模型最快但精度最低,large-v3精度最高但最慢 | 速度快,支持所有内置语言 |
openai-whisper(内置) | tiny模型最快但精度最低,large-v3精度最高但最慢 | 准确度略高但速度略慢,支持所有内置语言 |
Qwen-ASR(内置) | 中英日及其他十多种常见语言 | 中文识别效果好 |
阿里FunASR(内置) | 中英日为主,可选 paraformer/sensevoice/Fun-ASR-Nano多种模型 | |
Nemotron-3.5-asr-0.6b(内置) | 拉丁语系语言及日韩越等40种 | 英伟达开源模型 |
Moss-Diarize(内置) | 中文及其他十多种常见语言 | 90分钟内音视频支持返回说话人,无需单独分离模型 |
Whisper.cpp(Win内置) | faster-whisper变体,在Windows上已内置 whisper.cpp,可直接使用,MacOS和Linux上需自行单独部署 | whisper模型的c++版 |
Firered中文(内置) | 中文及中文方言视频 | 小红书开源模型 纯CPU运行 |
Dolphin亚洲语言(内置) | 东亚语言、东南亚及中东语言,专注亚洲小语种 | 纯CPU运行 |
OmnilingualASR(内置) | 支持所有内置语言,范围广 | facebook开源,支持语言多但效果不佳 纯CPU运行 |
识别模型:选择不同的识别渠道,会显示不同的模型,其中 faster-whisper/openai-whisper 渠道可供选择模型如下tiny→ 最快,准确度低base/small→ 平衡之选medium→ 较好效果large-v3→ 最佳效果,需要 8GB+ 显存large-v3-turbo→ 推荐,速度与质量兼顾tiny.en/base.en/small.en/medium.en/distil-large-v3/distil-large-v3.5针对英文优化的蒸馏模型,仅当 发音语言是 英语时可用
LLM纠错: 语音转录显然会存在 错别字、缺失标点等各种错误,LLM纠错是在识别完成后,将识别结果发给AI大模型,修正错别字、添加标点等,以得到更通顺流畅的结果,默认使用DeepSeek渠道,可在 菜单-工具--高级选项-语音识别参数-LLM纠错所用渠道里切换。LLM纠错提示词在软件目录/videotrans/prompts/resegment/llm.txt中,可自行修改调整LLM重新断句: 选中
菜单-工具-高级选项-语音识别参数--使用LLM重新断句替代LLM纠错后将使用LLM重新断句,提示词为软件目录/videotrans/prompts/resegment/llm_re.txt,选中后,请勿再嵌入双字幕,因重新断句必然导致字幕条数和原始字幕不匹配二次语音识别:
在选择了配音角色、同时没有选择嵌入双字幕时,可选中二次识别,将在配音完毕后,针对配音结果再次转录,生成简短的字幕嵌入视频,确保字幕和配音精确对齐
在高级选项--语音识别参数-二次识别最长时间和二次识别最短时间,设置较小的值有利于生成短小字幕
注意:在对生成后的配音进行二次识别时,固定使用faster-whisper语音识别渠道,默认使用large-v3-turbo模型,可在此区域切换其他模型。
明确指定发音语言,谨慎选择【自动检测】
明确指定发音语言,会让识别更准确
自 v4.12 起,在视频翻译界面 发音语言 下拉最底部增加了自动检测,用于无法预先知道的音视频翻译。 若选择了自动检测,必须注意:
- 确保
语音识别仅使用faster-whisper(内置)、openai-whisper(内置)、Qwen-ASR(内置),否则可能出现无法预知错误,因为多数渠道需要明确指定语言 - 翻译渠道如
Google(免费)/微软(免费),如果待翻译文本中有多种语言文本混合,例如简繁混合,必须明确指定语言而非使用自动检测,否则不会翻译,而是直接返回原文 - 请勿嵌入双字幕,可能出现未知错误
解决字幕太碎或太长
不同视频的语速、停顿习惯及背景噪声各异,直接识别可能会出现**字幕太碎(一词一行)或字幕太长(满屏大段文字)**的情况。您可以根据实际视频类型自定义切分规则。
默认效果:单条字幕时长通常在 5~8 秒,最短不低于 3 秒。
📍 设置入口
打开软件顶部菜单:工具/选项 -> 高级选项 -> 找到 【语音识别参数】
一、 核心参数详解
| 参数名称 | 单位与默认值 | 作用解析 |
|---|---|---|
| 最长语音持续 | 秒 (s) 默认: 5 | 限制单条字幕的“天花板”时长。 设为 5 代表期望字幕不超过 5 秒。为防止语句被生硬切断,系统会有约 1.5 倍缓冲(即最长可能达到 5×1.5 ≈ 7.5~8 秒)。👉 想强制字幕短小,可调低该值(如 3~4)。 |
| 最短语音持续 | 毫秒 (ms) 默认: 3000(1000ms = 1秒) | 限制单条字幕的“地板”时长(防止太碎)。 设为 3000 代表字幕时长至少 3 秒。未达到此时长通常不会独立成句,会与上下文合并。 👉 想允许“好的”、“谢谢”这种短词独立出现,可降低该值(如 1000~1500)。 |
| 静音分割持续 | 毫秒 (ms) 默认: 600 | 判断说话停顿多长时间才执行“切断”。 说话停顿超过 600 毫秒,系统就认为一句话结束了,另起新字幕。 👉 调大该值(如 800+):语句更完整连贯,但字幕更长。 👉 调小该值(如 200-400):切分更灵敏,字幕更短,但语气不连贯时容易过度断句。 |
二、 推荐预设
🎬 预设 A:短视频/快嘴解说(追求短小精悍、快节奏)
- 最长语音:
2或3秒 - 最短语音:
1000毫秒 (1秒) - 静音分割:
140毫秒 - 效果:字幕短、反应快,适合竖屏短视频、卡点解说。
- 最长语音:
🎙️ 预设 B:课程教学/纪录片/访谈(追求语句完整、逻辑清晰)
- 最长语音:
8或10秒 - 最短语音:
3500毫秒 (3.5秒) - 静音分割:
800毫秒 - 效果:字幕信息量大、不断句,适合慢语速、长难句。
- 最长语音:
二次识别参数(仅配音后有效)
如果勾选了 “二次识别”,系统会读取新生成的“配音音频”重新生成字幕。由于配音发音更清晰、节奏更规则,参数可以设得更加精细短小:
- 二次识别最长语音持续(秒):默认
1.5。建议区间1.0 ~ 2.0秒,让配音字幕更加紧凑。 - 二次识别最短语音持续(毫秒):默认
600。建议区间400 ~ 600毫秒,用于捕捉配音中的短促词汇。
步骤 3:选择翻译渠道
用于将语音识别出来的字幕翻译为目标语言的字幕

界面元素
翻译渠道:
| 渠道 | 说明 |
|---|---|
| DeepSeek | AI大模型翻译质量佳,DeepSeek 物美价廉推荐使用 |
Google(免费) | 默认 翻译质量尚可,国内需科学上网且VPN节点稳定 |
Microsoft(免费) | 无需代理,可能限流 |
Hy-MT2(内置) | 腾讯混元模型翻译,1.8B模型 |
M2M100(内置) | 本地模型翻译 |
| 其他AI翻译渠道 | 推荐首选AI翻译渠道+选中发送完整字幕 |
发音语言:视频中人物说的语言目标语言: 希望翻译成的语言发送完整字幕: 选中该复选框,AI渠道下将以包含时间轴的 srt 格式发送待翻译字幕,而非仅仅发送文本,翻译质量会更好。翻译术语表:在AI翻译渠道中,会自动添加术语表内容到翻译提示词中。点击该术语表按钮,在弹出的窗口中按照左边的原始语言术语和右边的翻译结果,逐行填写,例如:首席执行官=CEO
获取更佳翻译质量的关键设置
- 翻译结果中若有字幕出现空白行,说明翻译引擎自动合并了相邻字幕文本,
高级选项-字幕翻译--AI翻译渠道每批字幕行数和高级选项-字幕翻译--传统翻译渠道每批字幕行数都设为1,可改善,但翻译质量会降低,因缺失足够上下文 - 使用 AI 翻译时时,勾选
发送完整字幕— 翻译更自然 - 使用 AI 翻译渠道,将
AI翻译渠道每批字幕行数设为 100 或更大,配合支持超长上下文的模型 - 选中
高级选项-字幕翻译--AI翻译附带所有字幕做参考,可在翻译字幕时附带所有原文作为上下文参考,能取得更佳质量(v4.12-0908版本起) - 在使用 AI 翻译渠道时,如果各种办法处理后,仍觉翻译结果太长,导致配音时长严重超过原始语音时长,可选中
高级选项--字幕翻译--进一步精简翻译结果,选中后将在提示词末尾追加指令,要求极致精简翻译结果。该提示词可在软件目录/videotrans/prompts/fragment/last_prompt.txt中编辑修改
步骤 4:选择配音渠道(对字幕进行配音)
这一步将翻译好的目标语言字幕进行配音

界面元素
配音渠道:
| 渠道 | 说明 |
|---|---|
Edge-TTS(免费) | 默认推荐,微软免费接口,声音自然,支持所有内置语言 |
Qwen3-TTS(内置) | 阿里本地模型,效果好速度慢,支持克隆,中英日为主,十多种语言 |
| Audio.cpp(本地) | audio.cpp后端,可切换10多个不同TTS模型 |
F5-TTS(内置) | 中英法德意日韩越等,支持克隆 |
| fish.audio | 在线配音服务,可作为 Elevenlabs.io 的平替,效果较好,需到 fish.audio 网站开通会员 |
OmniVoice(内置) | 支持所有内置语言,支持克隆 |
Confucius(内置) | 支持中英等14种语言,支持克隆 |
ChatterBox(内置) | 拉丁语系为主,支持克隆 |
ZipVoice中英(内置) | 中英语言,支持克隆,纯CPU运行 |
Moss-TTS-Nano(内置) | 中英等20多种主要语言,支持克隆 |
Higgs-audio-v3(内置) | 中英等多语言,支持克隆,cuda加速需10G显存,cpu运行需20G内存 |
gTTS(免费) | 支持所有内置语言,Google家的,国内需科学上网且VPN节点稳定,效果一般般 |
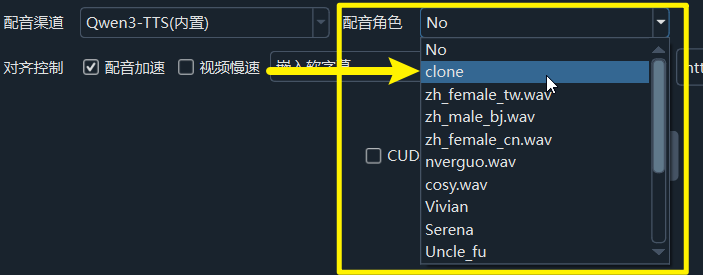
配音角色:选择渠道后,在配音角色下拉框中选择发音人(如果无发音人,请先选择目标语言),非clone配音角色可点击试听按钮预览声音。clone 角色:配音角色选中clone,代表将使用原始视频对应的音色进行配音,此时请确保最短字幕持续毫秒大于等于3000试听:如果所选角色可试听,将显示该按钮
步骤 5:字幕、配音、画面同步
一句话翻译为其他语言后,句子长度、音节数量、读出该句子用的时间,必然会发生变化,这是翻译后字幕配音画面不同步的根源。
可通过以下措施进行调整
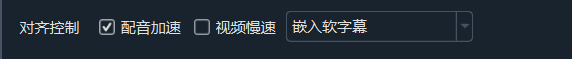
界面元素:
配音加速:✅ 默认选中,配音比原视频长时,加速配音匹配时长视频慢速: ☐ 默认不选 ,配音比原视频长时,放慢视频匹配配音删字幕间静音: ☐ 默认不选,如果配音加速和视频慢速均不选择,将显示该选项,选中后将删掉声音之间的静音片段,直接声音相连。若不选,则保留原始字幕之间可能存在的静音区间。对齐字幕声音: ☐ 默认选中,如果配音加速和视频慢速均不选择,将显示该选项,翻译为其他语言后的字幕,再进行配音,大概率与原语音时长不同,选中此项,将强制修改字幕时间戳,以便字幕能跟随声音显示和消失字幕嵌入类型: 默认嵌入软字幕,字幕嵌入到画面(若需网页播放,请选嵌入硬字幕)网络代理:某些服务例如Google,在中国大陆无法访问,若需使用,必须在此填写代理地址,格式如http://127.0.0.1:7890, 请确保所填写的代理已启动并且端口正确,若不懂,请保持为空,勿随意填写
提高对齐精度 打开 菜单-工具/选项--高级选项-字幕配音
- 移除每条字幕配音开头结尾静音缓冲: 选中可将配音开头和末尾的静音缓冲移除,利于对齐
- 移除每条字幕配音全部静音缓冲: 选中可将所有静音包括开头 末尾以及句中的静音缓冲全部移除,利于对齐
- 静音移除力度: 选择
low会降低移除力度,减小移除的静音片段,选择max将增大移除力度,移除更多静音片段 - 使用AI翻译渠道,可选中
高级选项--字幕翻译--进一步精简翻译结果,选中后将在提示词末尾追加指令,要求极致精简翻译结果。该提示词可在软件目录/videotrans/prompts/fragment/last_prompt.txt中编辑修改
不同字幕嵌入类型:
- 不嵌入字幕:只替换声音
- 嵌入硬字幕:字幕永久烧录到画面,网页中播放也会显示字幕
- 嵌入软字幕:默认,字幕作为独立轨道,播放器可开关,网页中播放不会显示字幕
- 嵌入硬字幕(双语):同时显示原文和译文(二次识别会被禁用)
- 嵌入软字幕(双语):双语字幕,播放器可开关(二次识别会被禁用)
步骤 6:开始执行
导入发音语言srt:如果已有原始srt字幕,不想再次识别,可点击该按钮导入,注意仅单视频模式有效导入目标语言srt:如果已有翻译好的目标语言srt字幕,不想再次翻译,可点击该按钮导入,注意仅单视频模式有效CUDA加速:如果你有英伟达显卡,并且配置好了 CUDA12.8 和 cuDNN9,可选中,语音识别阶段速度数倍提升开始执行:点击开始执行按钮,底部进度条实时显示进度,点击打开输出文件夹,完成后翻译视频自动保存到输出文件夹。
单视频模式:如果一次只选择一个视频,将在处理过程中弹出3-4次编辑界面,你可在界面中编辑字幕、重新配音、预览视频等,具体界面和操作方法查看单视频模式
五、设置更多参数,提高语音识别质量
例如 降噪、保留原视频中背景声音、识别分离说话人、调整语速、音量等,可通过点击 设置更多参数 来实现
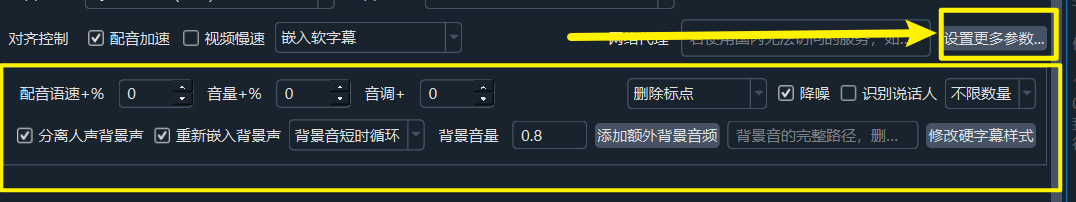
点击 设置更多参数.. 展开界面如下:
| 界面元素 | 说明 |
|---|---|
| 降噪 | 清除背景噪声,默认使用onnx模型并始终在cpu上处理,若有英伟达显卡可在高级选项--降噪模型中选择zipenhancer模型,将使用audio.cppGPU加速 |
| 默认标点/恢复标点/删除标点 | 选择删除标点,会将所有标点使用空格替换,恢复标点会尝试恢复丢失的标点符号 |
| 分离人声背景声 | 将人声与背景音乐分离,默认使用onnx模型始终在cpu上处理,若有英伟达显卡可在高级选项--人声背景分离模型中选择mel_band_roformer,将使用audio.cpp和mel-band-roformer-q8_0.gguf模型在GPU上加速执行 |
| 重新嵌入背景声 | 在配音完成后,将背景声重新混入配音中 |
| 背景音量 | 调整背景音量(0.0-2.0) |
| 背景音短时拉长/循环 | 选择当配音时长大于背景时长时如何处理:背景音短时拉长或背景音短时循环 |
| 配音语速 | 调整配音速度(-50% ~ +100%) |
| 音量调整 | 调整配音音量(-95% ~ +200%) |
| 音调 | 调整配音音调(-100Hz ~ +100Hz) |
| 识别说话人 | 选中后,在单视频模式下会尝试分离出各个说话人,供后续编辑窗口使用,在高级选项--语音识别参数--说话人分离模型可选择不同模型 |
| 不限数量 | 选择说话人的可能数量,若已知说话人数量,请在此选择,能提高精确度 |
| 修改硬字幕样式 | 点击将打开硬字幕样式编辑器 |
六、无损视频输出
确保满足以下所有条件,输出视频保持原始画质:
- 原始视频编码为 H.264 的 MP4 文件
- 不得勾选 视频慢速
- 不得 嵌入硬字幕
菜单--工具/选项--高级选项--视频输出--264/265编码选择264
七、提高翻译质量
语音识别渠道选择:- 首选 faster-whisper/openai-whisper, 模型推荐 large-v3,若显存不足,次选 large-v3-turbo。
- 进一步提高中文质量,可选
Qwen-ASR/阿里FunASR/豆包语音识别大模型极速版等 - 小语种推荐
openai-whisper+large-v3模型,或GeminiAI,或Huggingface_ASR中针对该语言的专门模型 - 拉丁语系语言除
faster-whisper/openai-whisper外也可尝试nemotron-stream-0.6b - 选中
LLM纠错复选框,并在高级选项--LLM纠错所用渠道里选择智能顶尖的AI渠道和模型 - 考虑LLM重新断句: 选中
菜单-工具-高级选项-语音识别参数--使用LLM重新断句替代LLM纠错后将使用LLM重新断句,提示词为软件目录/videotrans/prompts/resegment/llm_re.txt,选中后,请勿再嵌入双字幕,因重新断句必然导致字幕条数和原始字幕不匹配
字幕翻译渠道选择:- 首选 AI 渠道,例如 deepseek / openai-chatgpt / 智谱AI等,并使用在线旗舰模型,例如
deepseek-flash等 - 选中
发送完整字幕复选框 - 若所用模型上下文足够大, 并且不在意token消耗倍增,可选中
高级选项--字幕翻译--AI翻译附带所有字幕做参考 - 如果想进一步精简翻译结果,避免太长导致配音严重超长,可选中
高级选项--字幕翻译--进一步精简翻译结果 - 有能力可以自行优化提示词,位于
软件目录/videotrans/prompts/srt文件夹内(必须选中发送完整字幕),不同渠道对应不同的 txt 文件,打开编辑即可,注意其中的{xxx}是动态变量,不要删除或修改。未选中发送完整字幕时的提示词位于软件目录/videotrans/prompts/text内,Hy-MT2提示词也在该文件夹内。
- 首选 AI 渠道,例如 deepseek / openai-chatgpt / 智谱AI等,并使用在线旗舰模型,例如
配音渠道选择:- Edge-TTS 渠道支持所有内置语言,如果是冷门小众语言,请选此
- 提高中文配音效果:可尝试 豆包语音2.0、Fish-audio、Index-TTS、Qwen-TTS等
- 需要克隆原视频音色:可尝试带有
clone配音角色的渠道,例如OmniVoice/Qwen-TTS/Audio.cpp/GPT-SoVITS/F5-TTS/Confucius等
同步对齐:- 可先尝试仅仅选中
配音加速(仅加快语速,不改变画面) - 若效果不满意,可尝试同时选中
视频慢速(慢放画面) - 若不希望语速和画面速率变化,可取消
配音加速和视频慢速,通过选中对齐字幕声音以及搭配选中或不选中删字幕间静音来实现对齐
- 可先尝试仅仅选中
八、高级选项参考
通过 菜单 -> 工具/选项 -> 高级选项 进入:
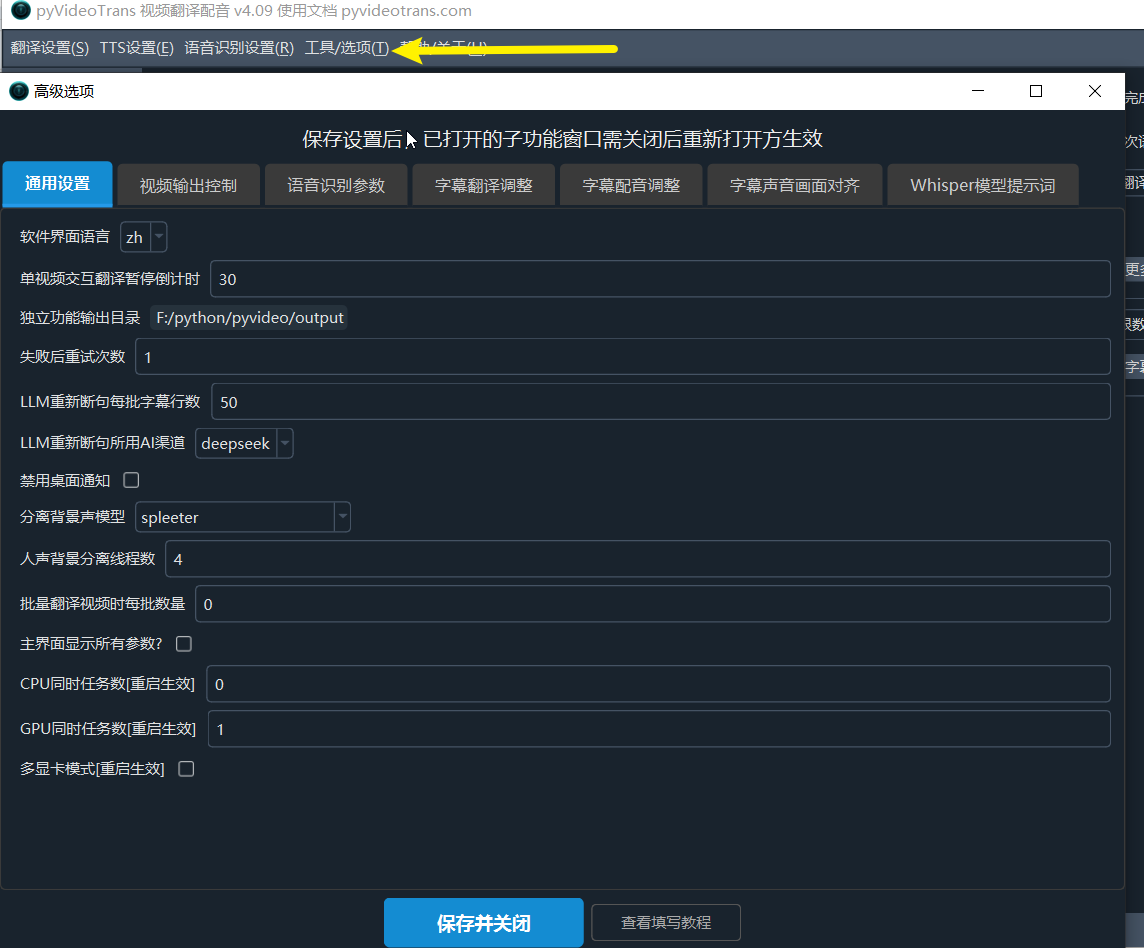
九、常见问题
为什么不同功能支持的语言数量不同?
核心原因:最终能支持哪些语言,取决于您当前选用的「底层模型」或「服务渠道」。不同模型和API在语种覆盖度上差异极大:
- 语音识别:
Whisper系列:覆盖最广,支持多达 99 种全球语言。Qwen-ASR等通用大模型:主打高质量识别,支持约 15 种常见主流语言。Firered中文等专用模型:属于针对性优化的垂直模型,仅支持单一语言(中文)。
- 语音合成 / 配音 (TTS):
Edge-TTS:微软生态,支持多达 80 种语言及各类方言。Qwen-TTS:目前覆盖约 10 种主流语言。ZipVoice等特色音色模型:仅支持中、英双语。
- 字幕翻译:
DeepL、腾讯翻译等传统翻译接口:深耕常见语种(10~30 种),翻译质量高但语种有限。大语言模型 (LLM):通过理解上下文翻译,几乎支持所有能被识别的自然语言。
视频翻译下拉菜单中目前共收录了约 80 种语言,在使用时请遵循以下规则:
1. 前 20~30 种常见语言(中、英、日、韩、法、德、西等)
- 兼容性最好: 软件已为各大翻译接口做好了专有的语言代码映射(Language Code)。
- 推荐渠道: 无论是传统翻译接口(DeepL、百度、腾讯),还是 AI 大模型(OpenAI、DeepSeek 等),均可稳定使用。
2. 后 50 种左右的小众语言 / 稀有语种
- 强烈建议:翻译渠道仅选择「AI 大语言模型」(如 DeepSeek / OpenAI / Gemini 等)!
- 为什么不能选传统接口?
- 接口本身不支持: 传统翻译渠道(如 DeepL、国内各类云厂商翻译)大多没有覆盖这些小语种。
- 语言代码不匹配(技术原因): 不同服务商对冷门语言的代码定义差异很大(例如同一语种,A 接口叫
fil,B 接口叫tl)。软件目前未对后 50 种冷门语言做全渠道的代码映射适配,强行使用传统接口极易直接报错中断。 - AI 模型的优势: AI 模型(LLM)基于语义理解,能够直接识别自然语言名称,无需严格依赖接口代码,容错率极高。
  "zh-cn": "简体中文",
  "zh-tw": "繁体中文",
  "yue": "粤语",
  "en": "英语",
  "fr": "法语",
  "de": "德语",
  "ja": "日语",
  "ko": "韩语",
  "ru": "俄语",
  "es": "西班牙语",
  "th": "泰国语",
  "it": "意大利语",
  "pt": "葡萄牙语",
  "vi": "越南语",
  "ar": "阿拉伯语",
  "tr": "土耳其语",
  "hi": "印度语",
  "hu": "匈牙利语",
  "uk": "乌克兰语",
  "id": "印度尼西亚",
  "ms": "马来语",
  "kk": "哈萨克语",
  "cs": "捷克语",
  "pl": "波兰语",
  "nl": "荷兰语",
  "sv": "瑞典语",
  "he": "希伯来语",
  "bn": "孟加拉语",
  "fil": "菲律宾语",
  "bg": "保加利亚语",
  "my": "缅甸语",
  "fi": "芬兰语",
  "el": "希腊语",
  "km": "高棉语",
  "lo": "老挝语",
  "nb": "挪威语(书面挪威语)",
  "ro": "罗马尼亚语",
  "uz": "乌兹别克语",
  "pt-br": "葡萄牙语(巴西)",
  "es-419": "西班牙语(拉美)",
  "fa": "波斯语",
  "ur": "乌尔都语",

# 以下语言建议翻译渠道里仅使用AI渠道,否则可能因其他渠道不支持该语言,或要求的语言代码不匹配而报错

  "af": "南非荷兰语",
  "sq": "阿尔巴尼亚语",
  "am": "阿姆哈拉语",
  "az": "阿塞拜疆语",
  "bs": "波斯尼亚语",
  "ca": "加泰罗尼亚语",
  "hr": "克罗地亚语",
  "da": "丹麦语",
  "et": "爱沙尼亚语",
  "gl": "加利西亚语",
  "ka": "格鲁吉亚语",
  "gu": "古吉拉特语",
  "is": "冰岛语",
  "iu": "因纽特语",
  "ga": "爱尔兰语",
  "jv": "爪哇语",
  "kn": "卡纳达语",
  "lv": "拉脱维亚语",
  "lt": "立陶宛语",
  "mk": "马其顿语",
  "ml": "马拉雅拉姆语",
  "mt": "马耳他语",
  "mr": "马拉地语",
  "mn": "蒙古语",
  "ne": "尼泊尔语",
  "ps": "普什图语",
  "sr": "塞尔维亚语",
  "si": "僧伽罗语",
  "sk": "斯洛伐克语",
  "sl": "斯洛文尼亚语",
  "so": "索马里语",
  "su": "巽他语",
  "sw": "斯瓦希里语",
  "ta": "泰米尔语",
  "te": "泰卢固语",
  "cy": "威尔士语",
  "zu": "祖鲁语",
"ug": "维吾尔语",💡 新手极简建议:
如果您翻译的是中、英、日、韩等大众语言,选哪个渠道都可以;
如果翻译的是小语种、冷门语言,翻译渠道无脑选 AI 模型(如 DeepSeek / ChatGPT)即可保证成功率。
Q: 能否同时启动多个 sp.exe 实例?
可以,但不建议,因多个实例共享同个tmp临时文件夹,并且任意一个实例关闭时,都会尝试清空该临时文件夹,可能导致其他在运行的实例报错。
如果确实需要,建议复制软件到其他文件夹内,然后再启动,例如一个在D:/aivideo下, 再复制一份到D:/aivideo2下,然后分别启动对应文件夹下的sp.exe,这样他们之间就互不影响
Q: 处理速度很慢?
- 确保已启用 GPU 加速(CUDA)
- 使用较小的模型
- 确保显卡驱动已更新
Q: 识别结果不准确?
- 检查「发音语言」是否选择正确
- 尝试更换更大的模型
- 设置更多参数中 开启「降噪」功能 或 分离人声背景声
- 调整「语音阈值」参数
Q: 翻译后声音、字幕、画面不同步?
这是正常现象。不同语言的音节数和语法结构不同,配音时长必然变化。解决方案:
- 启用「音频加速」(默认已启用)
- 可同时启用「视频慢速」
- 设置「配音语速」加快整体速度
Q: 输出视频文件太大?
- 增大「视频输出质量控制」的值(如 25-30)
- 将编码从 264 改为 265
- 关闭「视频慢速」
Q: 如何使用 GPU 加速?
确保已安装 NVIDIA 显卡驱动、CUDA 12.8 和 cuDNN 9.11,然后在主界面勾选「CUDA 加速」。AMD 显卡不支持 CUDA 加速。
Q: 无损视频输出的条件?
原始视频编码为 H.264 MP4 + 不勾选视频慢速 + 不嵌入硬字幕 + 编码选择 264
Q: 能否提取硬字幕、抹除硬字幕?
本软件无法直接提取或抹除视频画面已经内嵌的硬字幕。
- 如需提取硬字幕,请使用单独的硬字幕提取工具 本地离线提取视频硬字幕。 或 video-subtitle-extractor*
- 如需抹除删除硬字幕,推荐使用github开源项目video-subtitle-remover
Q: 一些特殊技巧
- 根目录下创建
netoffline.txt,强制 离线加载模型,若不存在模型将报错 - 根目录下创建
no_resegment.txt, 禁止 faster-whisper/openai-whisper 渠道重新根据字级时间戳断句,直接使用模型识别后的 句子作为每条字幕,将无法严格遵循 字幕最短时长和最大时长。(下载 v4.15 补丁包覆盖,即便已是v4.15完整包,仍需再次下载补丁包覆盖) - 根目录下创建
pyvideotrans_cpp.txt, 用于附在 whipser_cpp 命令行的其他参数 - 根目录下创建
pyvideotrans.txt, 用于附在 faster_xxl.exe 命令行的其他参数 - 根目录下创建
edgetts-noproxy.txt, 禁止 edge-tts 渠道走网络代理 - 根目录下创建
crf.txt, 视频慢速时的切片 crf 值,默认 18,越小清晰度越高,但处理越慢,所需硬盘空间越大 - 根目录下创建
preset.txt, 视频慢速时的切片 preset 值 'ultrafast', 'veryfast', 'medium', 'slow' 4选1,默认 veryfast,向右处理越来越慢但尺寸略小,向左反之 - 根目录下创建
huggingface.txt, 强制从 huggingface.co 下载模型,不走国内镜像站(但某些仅存在于modelscope.cn的模型仍会从源站下载)
相关文档
- 提高 AI 翻译字幕的质量 — 翻译模式对比与术语表使用
- 更好的使用本地大模型作为翻译渠道 — 本地大模型配置指南
- 修改 AI 翻译提示词 — 自定义翻译提示词
- 视频翻译最佳效果推荐 — 每个阶段的最优配置
- 翻译后出现"空白字幕行"的原因与解决方法